Roteador Sob Sobrecarga: Como o Alto Uso de CPU e Memória Colapsa Sistemas, Sessões BGP/OSPF e Aplicações Web
Em uma sala de guerra (war room) típica de um grande incidente de infraestrutura, os sintomas costumam ser desconcertantes. De repente, os alertas começam a disparar em massa: microsserviços falham ao se comunicar, chamadas de API externas retornam 504 Gateway Timeout, conexões com bancos de dados e instâncias de cache caem por tempo limite, e os usuários finais relatam travamentos severos e erros ERR_CONNECTION_TIMED_OUT.
A equipe de desenvolvimento examina os commits recentes e não encontra anomalias. Os DBAs monitoram as instâncias de PostgreSQL e MySQL e constatam que o consumo de IOPS e CPU está perfeitamente saudável. O time de SRE inspeciona os nós do Kubernetes e percebe que a utilização de recursos está abaixo de 20%.
Todos os servidores estão ociosos. Então, por que o ecossistema inteiro está colapsando?
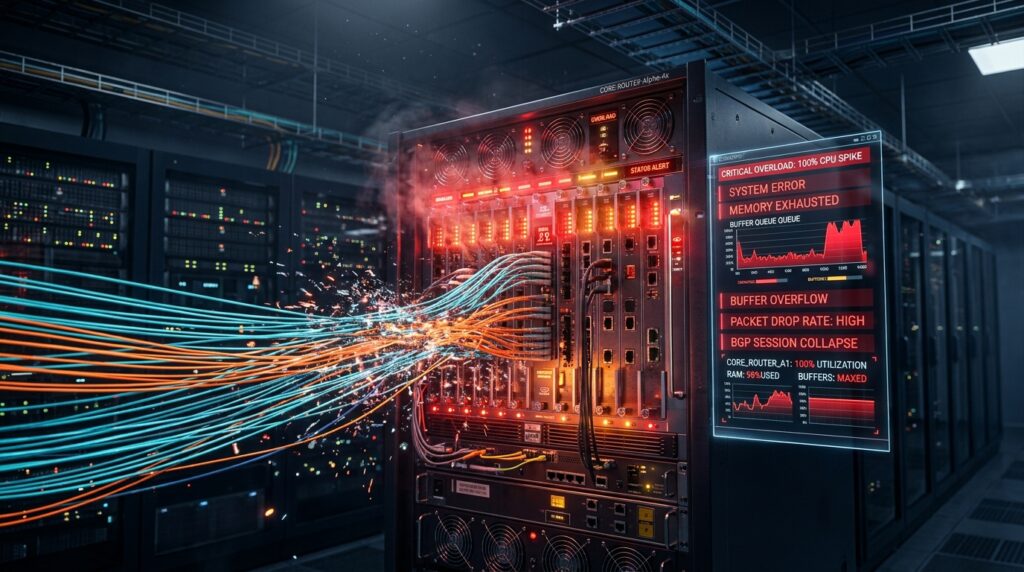
A resposta, na grande maioria das vezes, repousa no elemento mais crítico e frequentemente esquecido da topologia: o roteador de borda ou do core da rede corporativa. Quando um roteador atinge 100% de utilização de CPU ou esgota sua memória RAM/TCAM, ele não se limita a “ficar lento”. Ele desestabiliza a malha de encaminhamento de pacotes, derruba adjacências de protocolos dinâmicos de roteamento em cascata, induz bufferbloat extremo e gera um descarte massivo de pacotes de controle e dados que estrangula as aplicações na ponta.
Neste guia técnico definitivo, vamos dissecar a engenharia interna de roteadores corporativos e carrier-grade, entender a diferença vital entre Control Plane e Data Plane, analisar as causas reais do esgotamento de recursos, documentar o efeito dominó em sistemas distribuídos e estabelecer procedimentos cirúrgicos de diagnóstico e mitigação com Control Plane Policing (CoPP).
—
1. A Anatomia Arquitetural: Control Plane vs. Data Plane
Para compreender por que o alto uso de CPU e memória em um roteador é catastrófico, é fundamental desmistificar a arquitetura de hardware de rede. Diferente de um servidor convencional — onde a mesma CPU e memória RAM processam tanto o tráfego de entrada quanto a lógica da aplicação —, um roteador de arquitetura moderna opera sob uma estrita separação de planos.
O Data Plane (Forwarding Plane)
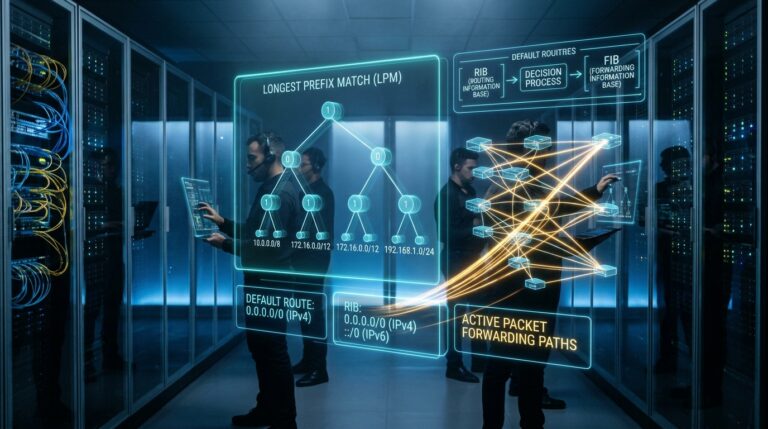
Construído sobre circuitos integrados específicos de aplicação (ASICs), processadores de rede (NPUs) e memórias associativas ternárias (TCAM). O Data Plane tem uma única missão: receber um pacote IP na interface física de entrada, consultar a tabela de encaminhamento em hardware (FIB – Forwarding Information Base) e despachá-lo pela interface de saída correta com a camada de enlace reescrita (novo cabeçalho Ethernet com MAC de destino).
Essa operação ocorre na velocidade do silício (wire-speed), processando centenas de milhões de pacotes por segundo (Mpps) com latências sub-microsegundo, sem qualquer interferência da CPU.
O Control Plane
O Control Plane é o “cérebro” estratégico do roteador. Ele roda sobre uma CPU convencional e memória RAM padrão, executando o sistema operacional de rede (como Cisco IOS-XE/XR, Juniper Junos, MikroTik RouterOS, VyOS ou distribuições Linux com FRRouting). Suas atribuições incluem:
- Executar os algoritmos de roteamento dinâmico (árvores SPF do OSPF, máquinas de estado e seleção de rotas BGP).
- Manter a tabela mestre de roteamento (RIB – Routing Information Base).
- Responder a mensagens de controle (resolução de ARP, NDP do IPv6, mensagens ICMP de tempo esgotado ou destino inalcançável).
- Negociar túneis VPN (trocas de chaves IKEv2 para IPsec).
- Programar periodicamente os chips do Data Plane (compilando a RIB na FIB de hardware).
O Ponto de Ruptura: O “Punting” de Tráfego
A CPU do Control Plane de um roteador de borda de 10 Gbps ou 100 Gbps costuma ser surpreendentemente modesta (frequentemente processadores quad-core de baixo consumo). Isso é intencional: ela foi dimensionada para processar alguns milhares de pacotes de sinalização por segundo, não para encaminhar pacotes de tráfego de dados.
Quando um pacote chega ao Data Plane e o hardware não consegue ou não deve encaminhá-lo sozinho, esse pacote é desviado para a CPU. Esse mecanismo é tecnicamente chamado de Punting (ou Process Switching / Software Forwarding). Se o volume de pacotes pontuados (punted packets) ultrapassar a capacidade da CPU, o Control Plane entra em colapso.
—
2. As Causas Raiz do Alto Uso de CPU no Roteador
A sobrecarga de processador em roteadores raramente decorre de volume bruto de banda em trânsito; ela decorre de anomalias arquiteturais, ataques ou tráfego malformado que força a interrupção da CPU.
1. ARP Glean e Varreduras de Rede (Scanners)
Se uma sub-rede corporativa alocada no roteador possui a máscara /24 (254 hosts utilizáveis), mas apenas 30 servidores estão ativos, os outros 224 IPs estão vagos.
Se um invasor externo ou um malware interno iniciar uma varredura de portas em massa contra essa rede, pacotes chegarão ao roteador endereçados a esses 224 IPs. O ASIC da FIB verifica a tabela de adjacência e nota que não possui o endereço MAC desses destinos (estado Incomplete). O ASIC não tem a capacidade de gerar pacotes ARP Request por conta própria; portanto, ele transfere cada um desses pacotes para a CPU.
A CPU aloca memória para enfileirar o pacote original (packet hold buffer), monta um frame ARP Request em broadcast e aguarda resposta. Em um ataque com milhares de pacotes por segundo contra faixas inteiras /16 ou /20, a fila de entrada (ARP Input) consome 100% da CPU imediatamente.
2. BGP Churn e Tempestades de SPF no OSPF
Na Internet atual (a chamada Default-Free Zone ou DFZ), uma tabela completa de rotas BGP (Full Routing Table) ultrapassa 960.000 prefixos IPv4 e 210.000 prefixos IPv6. Roteadores corporativos de borda que mantêm múltiplas sessões com provedores de trânsito recebem milhões de anúncios de rotas.
Se um provedor upstream sofre instabilidade de fibra ou problemas de hardware, milhares de anúncios de retirada (BGP Withdraw) e novos caminhos (BGP Update) inundam a sessão. O processo BGP na CPU é obrigado a recalcular o algoritmo de melhor caminho (BGP Best Path Selection) para centenas de milhares de prefixos consecutivamente. Durante o processamento desse BGP Churn, a CPU crava em 100% por minutos a fio.
O mesmo ocorre em redes internas grandes com OSPF ou IS-IS mal sumarizados: qualquer oscilação de porta de acesso recalcula toda a árvore de caminho mais curto (algoritmo de Dijkstra), gerando picos brutais de CPU.
3. Pacotes com TTL=1 e Opções IP
O encaminhamento por hardware foi desenhado para o cabeçalho IP limpo de 20 bytes. Se um pacote contém o campo IP Options preenchido (como Record Route ou Strict Source Routing), quase nenhum ASIC corporativo processa o cabeçalho em hardware: o pacote é desviado para a CPU.
Similarmente, pacotes cujo campo TTL (Time to Live) ou Hop Limit chega ao roteador com valor igual a 1 não podem ser encaminhados; o roteador precisa descartá-los e responder com uma mensagem ICMP Time Exceeded (Tipo 11, Código 0). A geração desse pacote ICMP é uma tarefa exclusiva da CPU. Ferramentas massivas de auditoria ou loops de roteamento temporários geram tempestades de TTL=1 que esmagam o Control Plane.
—
3. As Causas Raiz do Esgotamento de Memória (RAM e TCAM)
Enquanto a CPU responde pela velocidade de cálculo, a memória define a capacidade estrutural do roteador de reter estados e tabelas. O esgotamento de memória ocorre em dois níveis distintos:
Esgotamento da Memória RAM (Control Plane)
1. Multiplicação de Tabelas BGP sem Agregação: Roteadores que recebem Full Table de dois provedores e configuram comandos como soft-reconfiguration inbound duplicam desnecessariamente cada prefixo na memória (armazenando a tabela recebida inalterada além da Loc-RIB). Isso consome de 1.5 GB a 3 GB adicionais de RAM por sessão.
2. Vazamentos de Memória (Memory Leaks): Bugs em daemons de controle (como o processo Zebra ou BGPd em FRRouting, ou processos de telemetria gNMI em roteadores corporativos) que falham em desalocar memória após alterações contínuas de topologia.
3. Esgotamento da Tabela de Estados (Conntrack / NAT Exhaustion): Em roteadores de borda que também realizam tradução de endereços de rede (NAT/CGNAT) ou inspeção stateful, cada conexão TCP, UDP e ICMP exige uma entrada na tabela de rastreamento. Se um ataque SYN Flood ou uma avalanche de conexões de clientes saturar o limite do kernel (ex: nf_conntrack_max no Linux), a alocação de memória para novos buffers é negada, ou o kernel dispara o temido OOM Killer (Out of Memory), matando processos vitais.
Esgotamento de TCAM (Hardware Forwarding Plane)
A memória TCAM é extremamente rápida, mas cara e fisicamente restrita. Ela possui slots fixos para armazenar rotas da FIB, regras de ACL de firewall e políticas de QoS.
Se o número de rotas aprendidas pela CPU excede o limite físico da TCAM do equipamento (por exemplo, instalar 1 milhão de rotas em um switch de camada 3 com capacidade máxima de TCAM para 512k prefixos), o roteador reage de duas maneiras perigosas:
1. Descarte de Novas Rotas: O hardware para de programar prefixos na FIB. O tráfego para redes válidas é descartado silenciosamente.
2. Fallback para Software Switching: O roteador tenta rotear os prefixos excedentes através da CPU. O resultado é o colapso instantâneo da CPU em 100%, derrubando toda a máquina.
—
4. O Efeito Dominó nos Sistemas Distribuídos e Aplicações
O colapso de CPU ou memória em um roteador não permanece isolado na camada de rede. Ele reverbera em cadeia por toda a pilha tecnológica, atingindo diretamente servidores, microsserviços e bancos de dados.
1. Queda de Adjacências de Roteamento em Cascata (BGP Flap)
O sintoma mais destrutivo do alto uso de CPU em roteadores de borda é o rompimento de sessões BGP e OSPF:
- Em uma sessão BGP padrão, os pares enviam mensagens periódicas de
KEEPALIVE(geralmente a cada 30 ou 60 segundos). O tempo limite de espera (Hold Time) é configurado tipicamente para 90 ou 180 segundos. - Se a CPU do roteador passar 90 segundos cravada em 100% processando uma tempestade de ARP ou pacotes de exceção, o processo BGP não recebe tempo de CPU suficiente para gerar ou ler o Keepalive do socket TCP.
- O roteador vizinho atinge o timeout:
Hold Timer Expired. A sessão cai. - O Desastre em Cadeia: Ao derrubar a sessão, o roteador vizinho retira todos os anúncios daquele roteador da Internet. O tráfego para de chegar, o que faz a CPU do roteador sobrecarregado finalmente cair para 10%. Sentindo-se livre, o roteador reconecta o BGP e anuncia suas rotas novamente.
- Minutos depois, uma nova carga entra, a CPU volta a 100%, o BGP cai de novo. Esse ciclo interminável de BGP Flapping isola filiais, escritórios e datacenters inteiros da Internet.
2. Bufferbloat e Latência Errática
Quando um roteador sofre com gargalo de processamento, as filas de interface (input queues e output buffers) enchem até o limite máximo. Em vez de descartar os pacotes imediatamente para forçar os transmissores TCP a reduzir a janela, buffers superdimensionados seguram os pacotes por centenas de milissegundos.
Esse fenômeno, conhecido como Bufferbloat, faz o tempo de ida e volta (RTT) entre uma aplicação web e seu banco de dados saltar de saudáveis 1.5 ms para assustadores 2.800 ms. A conexão não cai, mas fica tão lenta que todas as requisições síncronas de microsserviços sofrem timeout.
3. Falha de Resolução DNS e Timeouts em Microsserviços
O protocolo DNS depende primordialmente de transporte UDP na porta 53. Como o UDP não possui controle de fluxo, retransmissão ou janela de congestionamento nativa, pacotes DNS que chegam a uma interface saturada sofrem descarte de cauda (tail drop).
Microsserviços em clusters Kubernetes ou instâncias de nuvem que tentam resolver nomes de domínios internos ou APIs externas começam a receber falhas de resolução (NXDOMAIN, SERVFAIL ou i/o timeout). Como grande parte das aplicações não implementa resiliência de DNS com fallback robusto, o aplicativo aborta a operação.
4. Exaustão de Connection Pools no Backend
Em servidores de aplicação (como Node.js, PHP-FPM, Spring Boot, ASP.NET Core e Gunicorn), requisições HTTP dependem de pools de conexão com bancos de dados relacionais e serviços de cache.
Quando o roteador intermediário descarta pacotes ou impõe latências desmedidas:
1. Conexões de banco de dados levam 5 segundos para completar um simples SELECT que antes levava 2 ms.
2. Cada thread ou worker do servidor web permanece bloqueado esperando a resposta da rede.
3. Rapidamente, todas as conexões do pool atingem o limite máximo (max_connections ou pool_size = 100).
4. Novas requisições de clientes legítimos chegam ao servidor web, não encontram conexões disponíveis no pool e são rejeitadas instantaneamente com HTTP 500 / 503 Service Unavailable.
—
5. Auditoria e Diagnóstico em Produção (Multi-Vendor)
Quando o alarme de incidente tocar, o operador de redes ou o SRE precisa saber exatamente quais comandos rodar para isolar a causa raiz em segundos.
Diagnóstico no Cisco IOS / IOS-XE
—
Diagnóstico em Roteadores Linux / VyOS / FRRouting
—
Diagnóstico no MikroTik RouterOS
—
6. Arquitetura de Defesa, Mitigação e Hardening de Engenharia
Para garantir que a CPU e a memória do roteador permaneçam protegidas mesmo durante ataques distribuídos de negação de serviço ou oscilações violentas de BGP, a engenharia de redes adota padrões rígidos de proteção arquitetural.
1. Control Plane Policing (CoPP)
O Control Plane Policing (CoPP) é uma técnica obrigatória em qualquer roteador corporativo ou carrier-grade. Ele trata o Control Plane como uma entidade protegida por regras estritas de QoS e firewall interno, aplicando rate-limiting e policiamento de tráfego antes que os pacotes alcancem o processador.
Exemplo de implementação robusta de CoPP no Cisco IOS-XE:
Com essa política aplicada em hardware:
- Se um ataque DDoS enviar 10 milhões de pacotes ICMP por segundo contra o IP do roteador, o ASIC descartará 9,9 milhões e deixará passar apenas 1 Mbps para a CPU.
- As mensagens de
BGP KeepaliveeOSPF Hellopassam intactas na classe crítica. - A sessão BGP jamais cairá por sobrecarga de tráfego de exceção.
—
2. BFD (Bidirectional Forwarding Detection) em Hardware
Protocolos de roteamento tradicionais usam seus próprios keepalives lentos para detectar se o vizinho morreu (dezenas de segundos). Para acelerar a convergência para milissegundos sem sobrecarregar a CPU, adota-se o protocolo BFD.
Em roteadores modernos, as sessões BFD são descarregadas e respondidas diretamente nos ASICs/NPUs de linha (Hardware-Offloaded BFD). Mesmo que a CPU do Control Plane sofra uma carga repentina temporária, o hardware continua respondendo aos ecos de BFD, impedindo a queda desnecessária de rotas da empresa.
—
3. Tuning de Conntrack e Timeouts TCP (Roteadores Linux / Firewalls)
Se a sua empresa utiliza appliances baseados em Linux para roteamento e NAT (como VyOS ou nós gateways em Cloud), dimensione os limites do kernel para evitar o estouro de memória da tabela de estados:
—
4. Proteção de Memória BGP: Maximum-Prefix e Soft-Reconfiguration
Para blindar o roteador contra estouro de memória RAM provocado por provedores enviando rotas incorretas ou vazamentos globais (BGP Route Leaks):
—
7. Métricas Essenciais e Alertas Preditivos (Prometheus / SNMP)
Esperar a aplicação cair para descobrir que o roteador de borda está sobrecarregado é inaceitável em ambientes corporativos modernos. Monitore as seguintes métricas via SNMP, gNMI Streaming Telemetry ou Prometheus Exporters:
| Métrica / Telemetria | Threshold de Alerta (Warning) | Threshold Crítico (Disparo Imediato) | Ação Recomendada |
|---|---|---|---|
| **CPU Utilization (5 min avg)** | > 75% | > 90% | Inspecionar processos via CLI; checar se há BGP Churn ou ARP storm |
| **Available RAM** | < 20% livre | < 10% livre | Checar tamanho de tabelas de rota e vazamentos de memória em daemons |
| **Conntrack / NAT Usage** | > 75% da capacidade | > 85% da capacidade | Expansão de tabela ou redução de timers de TCP FIN/TIME_WAIT |
| **Interface Input Queue Drops** | > 10 drops / seg | > 100 drops / seg | Policiamento imediato de tráfego de exceção na interface |
| **BGP State Changes (Flaps)** | > 0 eventos / 10 min | > 2 eventos / 10 min | Ativar BGP Route Flap Damping e acionar o provedor de trânsito |
| **Punt Policer Drops** | > 500 pps | > 5.000 pps | Roteador sob ataque direto ou scanner varrendo rede interna |
—
8. Runbook de Resposta a Incidentes: Roteador em Chamas
Quando o roteador entrar em estado de sobrecarga crítica durante o horário de pico comercial, jamais execute um reboot preventivo às cegas. Reiniciar um roteador sobrecarregado costuma piorar a situação: durante a inicialização, a convergência de todos os protocolos simultâneos e o download de rotas farão a CPU atingir 100% novamente, prolongando o downtime por mais 20 a 40 minutos.
Siga este procedimento operacional padronizado:
—
Conclusão
A infraestrutura de redes não é um mero encanamento transparente de dados: ela é o alicerce vivo sobre o qual todos os microsserviços, APIs, bancos de dados e sistemas corporativos dependem.
Quando um roteador atinge seus limites de CPU e memória, ele não falha sozinho — ele arrasta consigo todo o ecossistema de aplicações através de quedas de BGP em cascata, tempestades de retransmissão TCP, bufferbloat incapacitante e falhas silenciosas de resolução DNS.
Compreender a separação rígida entre o Data Plane e o Control Plane, blindar o processador com Control Plane Policing (CoPP), manter a memória dimensionada contra o crescimento das tabelas globais e monitorar telemetrias preditivas são as marcas que diferenciam uma operação vulnerável a apagões de uma engenharia resiliente e preparada para alta escala.

Guilherme Nascimento
Especialista & FundadorEspecialista em Infraestrutura, Cloud/DevOps e Cibersegurança | +10 anos de experiência prática
Profissional com mais de uma década atuando no campo de batalha da tecnologia corporativa. Especialista em arquiteturas resilientes, automação com Docker/Kubernetes, Hardening de Active Directory, Linux avançado e observabilidade SRE. Criador do ecossistema Hora Nerd, dedicado a desmistificar a tecnologia para profissionais e estudantes.