O Apagão Aéreo da FAA: Como uma Manutenção de Roteador Paralisou os Céus dos EUA, os Prejuízos Bilionários e as Lições Críticas para Administradores de Redes e Empresas
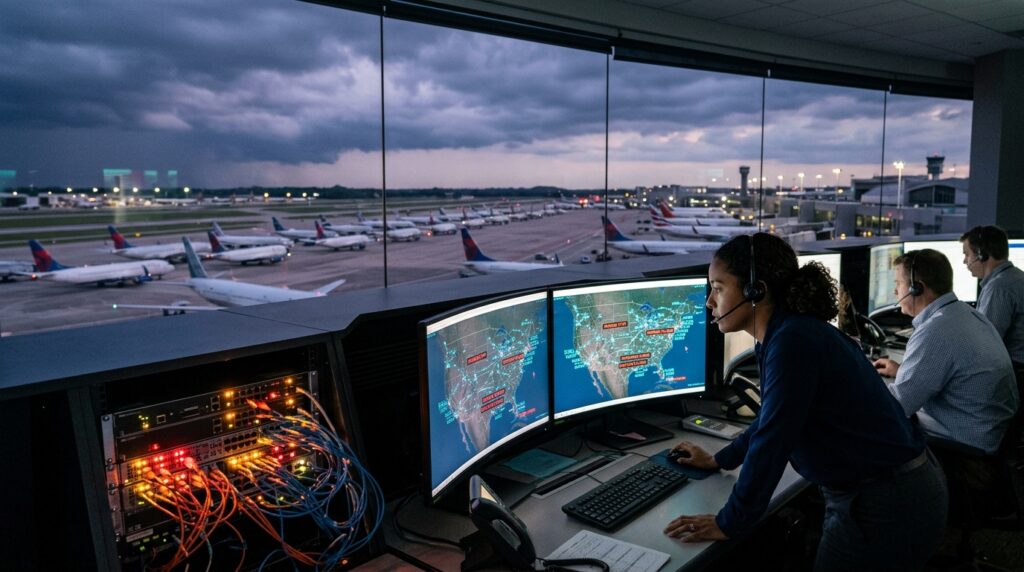
Imagine a cena: de costa a costa nos Estados Unidos, as telas dos aeroportos internacionais mais movimentados do planeta — Atlanta Hartsfield-Jackson, Chicago O’Hare, Dallas/Fort Worth, JFK em Nova York e Los Angeles LAX — começam a piscar simultaneamente com a cor vermelha. Nos consoles dos controladores de tráfego aéreo, as trilhas de radar começam a congelar, os planos de voo digitalizados desaparecem e as comunicações entre setores de alta altitude tornam-se intermitentes.
Em questão de minutos, a Federal Aviation Administration (FAA) toma a decisão operacional mais drástica e temida da aviação mundial: declarar um Ground Stop nacional, ordenando que nenhuma aeronave comercial decole em todo o território norte-americano.
Nos primeiros momentos de pânico, especulou-se sobre um ciberataque massivo patrocinado por estados-nação ou uma sabotagem em larga escala. No entanto, quando os relatórios preliminares de engenharia emergiram, a causa raiz revelou-se muito mais terrena, desconcertante e familiar para qualquer engenheiro de infraestrutura: uma falha de configuração e comportamento anômalo de um único roteador durante uma janela de manutenção rotineira de migração de cabos de telecomunicações.
A contratante governamental (L3Harris) estava substituindo enlaces legados de cobre por fibra óptica moderna em instalações remotas no Texas e Arkansas. Um novo equipamento de roteamento entrou em loop, disparou uma torrente incontrolável de requisições de conexão e inundou a espinha dorsal de telecomunicações da aviação, derrubando 17 dos 22 Centros de Controle de Tráfego Aéreo de Rota (ARTCCs) do país.
O resultado? Uma paralisação que gerou um efeito cascata destrutivo de 3 dias de atrasos, prejuízos acumulados que ultrapassaram a casa dos US$ 2 bilhões de dólares e uma das maiores crises de confiabilidade de infraestrutura crítica da década.
Neste artigo aprofundado, vamos realizar a autópsia técnica definitiva desse desastre: como pacotes fora de controle derrubaram as tabelas de roteamento da aviação, qual a matemática do prejuízo econômico para empresas e companhias aéreas, quais os contornos de emergência que evitaram tragédias maiores e, acima de tudo, como administradores de redes e gestores de negócios podem blindar seus ambientes contra colapsos semelhantes.
—
1. A Anatomia da Rede da FAA: O Que é a FTI?
Para entender a fragilidade do sistema, é preciso conhecer a infraestrutura subjacente. A espinha dorsal que conecta o controle de tráfego aéreo americano é conhecida como FTI (FAA Telecommunications Infrastructure).
A rede FTI conecta:
- 22 Centros ARTCC (Air Route Traffic Control Centers): Grandes instalações responsáveis por monitorar aeronaves em altitude de cruzeiro (acima de 18.000 pés).
- Mais de 500 Torres de Controle de Aeroportos (ATCT) e instalações de aproximação radar (TRACON).
- Centenas de estações de radar primário e secundário, antenas de telemetria ADS-B e estações meteorológicas.
- Sistemas ERAM (En Route Automation Modernization): O supercomputador de software que processa simultaneamente milhares de planos de voo e calcula trajetórias para evitar colisões.
Historicamente, grande parte das instalações remotas de radar e enlaces de telecomunicações operavam sobre circuitos analógicos e digitais legados de cobre (linhas T1/T3 e Telco antigas). Como parte de um programa de modernização multibilionário, a FAA e sua principal integradora, a L3Harris, iniciaram um plano massivo de migração para enlaces de fibra óptica de alta capacidade utilizando novos roteadores de borda.
Foi exatamente nessa transição que o desastre se materializou.
—
2. Autópsia Técnica: Como uma Manutenção de Roteador Derrubou 17 Centros Aéreos
O que acontece fisicamente e logicamente na rede para que um equipamento instalado a milhares de quilômetros de distância derrube radares em 17 estados americanos?
Como exploramos nos artigos anteriores sobre Tabelas de Roteamento na Prática e Roteador Sob Sobrecarga de CPU e Memória, a causa foi uma combinação letal de punição arquitetural de tráfego (Punting), tempestade de controle e ausência de proteção de CPU.
O Mecanismo da Falha Passo a Passo
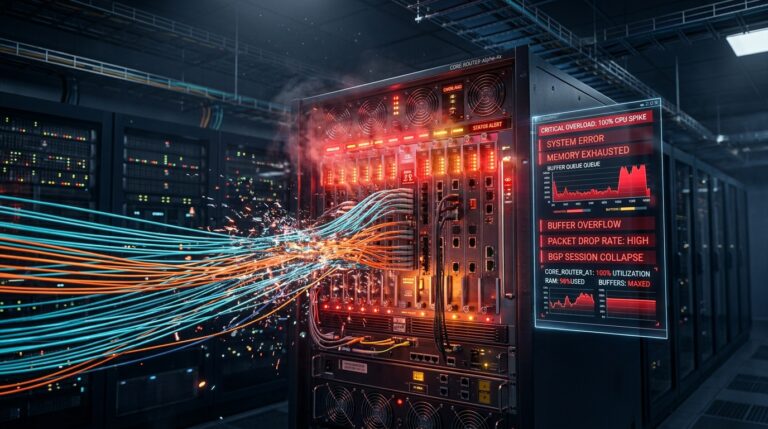
1. A Função Anômala de Broadcast: Durante o provisionamento do roteador recém-integrado à malha, uma funcionalidade de auto-descoberta, sincronização de vizinhança ou anúncio de broadcast entrou em loop. O equipamento começou a emitir aproximadamente 1.000 requisições de conexão a cada 4 a 5 segundos, direcionadas a múltiplos endereços IP de roteadores da rede operacional.
2. O Punting Forçado de Pacotes: Esses pacotes não eram tráfego comum de passagem (que os chips ASIC comutam instantaneamente em velocidade de fio). Por serem tentativas de conexão e sinalização direcionadas aos próprios roteadores da malha, os chips de hardware do Data Plane foram forçados a desviar (punt) cada pacote para a CPU do Control Plane.
3. Colapso da CPU (IP Input a 100%): Os roteadores dos 17 centros ARTCC viram suas CPUs de propósito geral cravarem em 100%. Com o processador totalmente afogado, o sistema operacional de rede entrou em degradação severa.
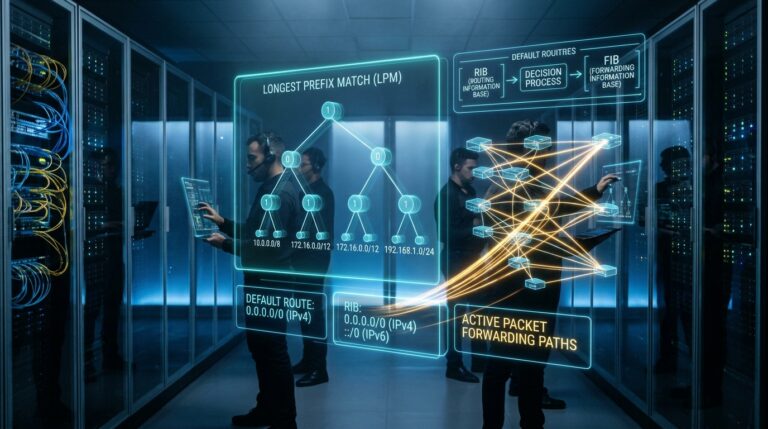
4. Desestabilização das Tabelas de Roteamento (RIB e FIB):
* Os processos de roteamento dinâmico não tiveram ciclos de CPU para processar mensagens de Keepalive e Hello.
Os temporizadores de expiração estouraram (Hold Timers Expired*). Enlaces vitais foram incorretamente considerados “mortos”.
A tabela de hardware (FIB) sofreu remoção de rotas em cascata (Route Flap). As rotas específicas que entregavam os dados de telemetria dos radares para os consoles dos controladores de tráfego aéreo deixaram de responder pelo algoritmo de Longest Prefix Match (LPM), caindo em descarte silencioso (Blackhole*).
5. O Congelamento das Telas de Radar: Sem a entrega pontual dos pacotes UDP de telemetria dos radares primários e com a rede paralisada por Bufferbloat (latências saltando de milissegundos para dezenas de segundos), as telas dos controladores congelaram.
Na aviação, operar com radar congelado ou atrasado significa o risco iminente de colisão entre aeronaves comerciais a 900 km/h. O protocolo de segurança é inegociável: interromper imediatamente todas as decolagens.
—
3. O Prejuízo Multibilionário de 3 Dias de Caos: O Efeito Chicote (Whiplash Effect)
Muitos leigos perguntam: “Se o roteador defeituoso foi isolado em cerca de 4 a 6 horas, por que o sistema aéreo demorou três dias para se normalizar?”
A resposta reside em um dos conceitos mais brutais da logística global: o Efeito Chicote Operacional. A aviação civil opera como uma engrenagem de precisão cirúrgica sem qualquer folga estrutural. Quando ela é paralisada por algumas horas, o tempo de recuperação é exponencialmente maior.
A Conta Financeira do Desastre
As estimativas econômicas de associações aéreas internacionais (IATA), órgãos governamentais e analistas de mercado calcularam o impacto cumulativo em números astronômicos:
| Categoria de Impacto | Custos e Perdas Estimadas | Impacto Operacional Real |
|---|---|---|
| **Companhias Aéreas (Airlines)** | **US$ 1.2 a US$ 1.5 Bilhão** | Reembolsos de passagens, multas de atraso, pagamento de hotéis, alimentação, horas extras e combustível queimado em espera (*holding patterns*). |
| **Logística e Carga Aérea (Cargo/Supply Chain)** | **US$ 450 a US$ 600 Milhões** | FedEx, UPS e fretes aéreos de alta prioridade paralisados: cargas perecíveis, fármacos refrigerados e insumos fabris *just-in-time* retidos nos centros de triagem. |
| **Setor de Turismo, Hotelaria e Eventos** | **US$ 500 a US$ 800 Milhões** | Diárias de convenções corporativas canceladas, reservas turísticas perdidas e queda na atividade de transporte terrestre e restaurantes. |
| **Produtividade Econômica Geral** | **US$ 1.0+ Bilhão** | Centenas de milhares de horas produtivas de executivos e trabalhadores perdidas em saguões e atrasos de reuniões de negócios. |
| **IMPACTO TOTAL ESTIMADO** | **> US$ 3.0 BILHÕES** | **Um dos maiores custos decorrentes de falha de rede da história dos EUA.** |
—
4. Contornos de Emergência: Como a Crise Poderia Ter Sido Mitigada em Voo?
Durante um colapso desse porte, que planos de contingência podem salvar a operação e evitar o travamento total da economia?
1. Separação Procedimental (Controle Manual)
Antes do radar, a aviação operava via separação procedural: os pilotos reportavam suas posições e altitudes via rádio VHF em pontos geográficos fixos (waypoints).
- Em caso de pane de rede de radar, o sistema aéreo pode transitar gradualmente para o modo procedural.
- Embora reduza a capacidade de pousos e decolagens de 100% para cerca de 30% a 40%, ela impede a paralisia total (Ground Stop absoluto), mantendo os voos internacionais e conexões essenciais em andamento com segurança estrita.
2. Isolamento Instantâneo de Raio de Explosão (Blast Radius Quarentine)
Durante o incidente real, demorou-se mais de duas horas apenas para que a equipe de engenharia identificasse qual equipamento específico estava gerando o dilúvio de pacotes.
- Em uma infraestrutura madura, ferramentas automatizadas de telemetria deveriam ter detectado a anomalia e acionado um mecanismo de Quarentena Automática (ou desligamento de porta via script de auto-remediação), isolando o novo roteador antes que ele contaminasse o segundo ARTCC.
—
5. O Manual de Blindagem para Administradores de Redes e Sysadmins
Se você gerencia redes corporativas, datacenters ou nuvens públicas, os erros cometidos na rede da FAA são um espelho de falhas que ocorrem diariamente em empresas de todos os portes.
Aqui está o que você deve implementar imediatamente em sua infraestrutura:
1. Implemente Control Plane Policing (CoPP) Rigoroso
Conforme detalhado no nosso artigo sobre sobrecarga de roteadores, a CPU do roteador nunca pode ser exposta a tráfego desenfreado.
2. Ative Storm Control e Rate Limiting em Portas de Acesso e Troncos
Nunca confie cegamente que um equipamento parceiro ou recém-instalado não emitirá tempestades de pacotes.
3. Isole Redes de Manutenção com VRFs (Virtual Routing and Forwarding)
O novo roteador jamais deveria ter sido conectado diretamente à mesma tabela de roteamento global dos centros operacionais durante uma etapa de testes.
- Utilize VRFs para manter o tráfego de comissionamento e manutenção estritamente isolado da VRF de tráfego de produção. Somente após testes de carga sintéticos a rota deve ser vazada (route leaking) ou migrada para a produção.
4. Adote a Filosofia de “Canary Deployments” e “Commit Confirmed”
Em NetOps e infraestrutura como código (IaC):
- Nunca altere a malha inteira de uma só vez. Altere um único nó periférico (Canary), valide por 48 horas e expanda gradualmente.
- Em switches e roteadores corporativos (Cisco IOS-XR, Junos, VyOS), utilize sempre o comando de rollback automático:
—
6. O Alerta para Quem Tem um Negócio: O Risco Invisível da Infraestrutura
Para CEOs, diretores de operações (COOs), CFOs e proprietários de empresas, o incidente da FAA traz lições corporativas que vão muito além dos comandos de terminal.
1. A Ilusão do SLA Jurídico
Contratos com grandes operadoras e terceirizadas de infraestrutura frequentemente contêm cláusulas de SLA (Service Level Agreement) que prometem disponibilidade de 99.99%.
- A Dura Realidade: Se o provedor falhar e seu negócio ficar três dias fora do ar, o contrato prevê apenas o abatimento proporcional da fatura daquele mês. Nenhum provedor de telecomunicações pagará os lucros cessantes, os clientes que abandonaram sua loja ou a destruição da reputação da sua marca.
- A resiliência da sua empresa é responsabilidade da sua própria arquitetura, não do departamento jurídico do seu fornecedor.
2. Auditoria e Risco de Terceiros (Vendor Risk Management)
A FAA terceirizou a gestão de telecomunicações para uma empresa de renome mundial. Mesmo assim, o erro ocorreu porque faltou supervisão nos processos operacionais da contratada.
- Pergunta para a sua diretoria: Você sabe exatamente quem tem acesso aos roteadores de borda, firewalls e provedores de nuvem da sua empresa?
- Quais os critérios de homologação exigidos quando uma empresa terceirizada realiza manutenção nos seus servidores?
3. O Teste do “Modo Guerra”: Seu Negócio Sobrevive 72 Horas Offline?
A maioria das empresas modernas assume como premissa absoluta que a Internet e a computação em nuvem nunca falham. Quando uma catástrofe ocorre:
- Seus pontos de venda (PDVs) físicos continuam faturando em modo offline?
- Sua equipe tem canais alternativos de comunicação fora do ecossistema principal?
- Existe um plano de contingência documentado e treinado anualmente pela equipe?
Se a resposta for “não”, sua empresa não tem um plano de continuidade; ela tem apenas sorte temporária.
—
Conclusão: A Fragilidade do Mundo Digital
O apagão dos voos nos Estados Unidos é um lembrete implacável de que o mundo moderno — com sua complexidade de microsserviços, inteligência artificial, transações financeiras em tempo real e jatos supersônicos — ainda depende da física silenciosa de cabos, silício e pequenos pacotes trafegando em tabelas de roteamento.
Quando engenheiros e líderes negligenciam as regras fundamentais de isolamento de rede, proteção de Control Plane e gestão de riscos em manutenções, um único equipamento defeituoso pode derrubar uma nação de joelhos.
Para quem cuida de redes: blinde sua CPU, limite seus broadcasts e nunca confie em uma nova conexão sem quarentena. Para quem comanda negócios: diversifique seus provedores, teste seus planos de contingência e entenda que a resiliência tecnológica é o seguro de vida da sua empresa.

Guilherme Nascimento
Especialista & FundadorEspecialista em Infraestrutura, Cloud/DevOps e Cibersegurança | +10 anos de experiência prática
Profissional com mais de uma década atuando no campo de batalha da tecnologia corporativa. Especialista em arquiteturas resilientes, automação com Docker/Kubernetes, Hardening de Active Directory, Linux avançado e observabilidade SRE. Criador do ecossistema Hora Nerd, dedicado a desmistificar a tecnologia para profissionais e estudantes.