Houve um tempo em que os servidores corporativos eram tratados como animais de estimação (Pets). Eles tinham nomes carinhosos e mitológicos: Zeus, Thor, Netuno ou Fenix.
O Administrador de Sistemas — carinhosamente apelidado de SysAdmin — conhecia a personalidade de cada uma dessas máquinas. Ele sabia exatamente qual disco rígido no rack 4 rangia ao ligar, decorava de cabeça os IPs fixos de cada interface de rede e guardava em um caderno secreto os comandos artesanais necessários para reiniciar o servidor de banco de dados sem corromper as tabelas.
Se o Zeus ficasse doente, o SysAdmin passava noites acordado na sala fria do datacenter, cercado pelo ruído ensurdecedor dos ventiladores e pelo ar-condicionado de precisão, aplicando remendos cirúrgicos para mantê-lo respirando.
Essa era acabou.
Com a explosão da computação em nuvem, a proliferação de microsserviços e o nascimento de plataformas que atendem milhões de clientes simultâneos, o modelo artesanal de administração de sistemas ruiu. Nenhuma empresa moderna consegue sobreviver dependendo do conhecimento tribal de um técnico que precisa logar via SSH máquina por máquina para alterar um arquivo de configuração.
Foi dessa ruptura histórica que emergiu a disciplina mais valorizada da engenharia de infraestrutura moderna: o SRE (Site Reliability Engineer).
Neste artigo definitivo, exploramos a jornada de transformação do SysAdmin tradicional até o Engenheiro de Confiabilidade de Sistemas, detalhando as mudanças culturais, técnicas e arquiteturais que toda empresa e profissional de TI precisa compreender para não se tornar obsoleto.
🏛️ A Era dos “Pets”: O SysAdmin Tradicional
Nos anos 1990 e 2000, o sucesso de uma operação de TI dependia quase que exclusivamente da capacidade heroica do SysAdmin.
O trabalho era predominantemente físico e reativo:
* Provisionamento Manual: Para colocar um novo servidor no ar, a empresa abria uma ordem de compra, aguardava 45 dias para o chassi chegar da Dell ou HP, montava os trilhos no rack, passava cabos de rede com crimpador na mão e instalava o sistema operacional via CD-ROM ou pendrive.
* A Configuração Única (Snowflake Servers): Cada servidor tornava-se um “floco de neve” — único, irrepetível e frágil. Se a máquina queimasse, ninguém sabia reconstituir 100% das permissões, dependências e pacotes que foram instalados manualmente ao longo de cinco anos.
* O Mito da Janela de Manutenção de Madrugada: Toda alteração crítica era empurrada para as madrugadas de sábado para domingo, onde o SysAdmin virava a noite rezando para que o backup em fita magnética funcionasse caso o update desse errado.
[ Era Clássica do SysAdmin ]
  - Servidores tratados como Pets (com nome próprio e apego emocional)
  - Configurações manuais via terminal ou GUI
  - Resolução por reboot e inspeção manual de logs
  - Silo estrito: Dev entrega o arquivo .WAR/.ZIP, SysAdmin se vira para rodar
⚡ O Ponto de Ruptura: A Nuvem e a Transição de “Pets” para “Cattle”
A virada de chave começou quando o setor de tecnologia adotou a célebre metáfora criada por Randy Bias: “Pets vs. Cattle” (Animais de Estimação vs. Gado):
A Regra Pets vs. Cattle:
> No modelo legado, os servidores eram Pets: se ficavam doentes, nós os cuidávamos com remédios artesanais.
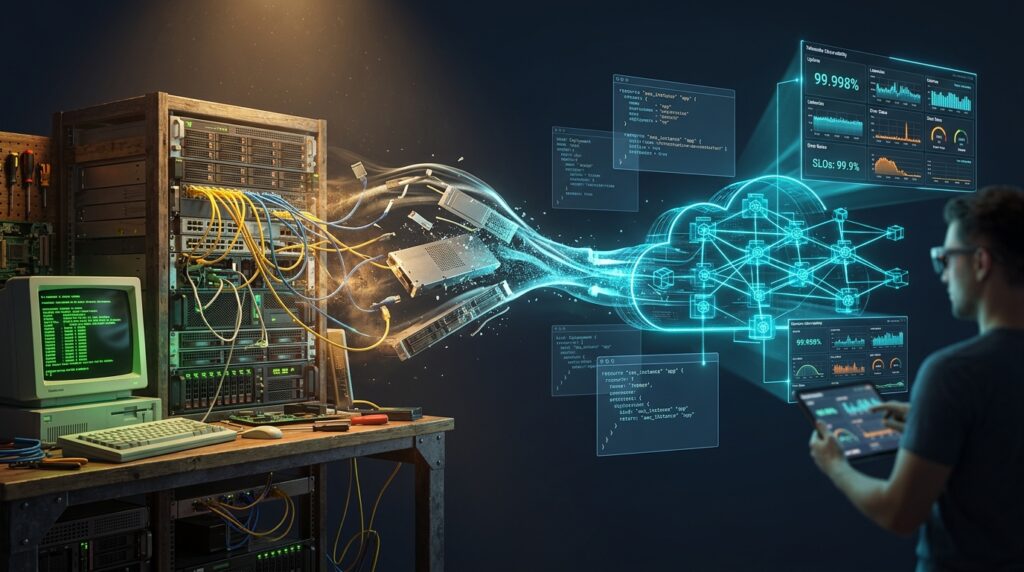
> Na nuvem moderna, servidores são Cattle (Gado): eles não têm nomes próprios, são numerados em série (ex: web-node-001, web-node-002). Se um deles fica doente ou apresenta lentidão, nós não perdemos tempo investigando: nós o destruímos sumariamente e um script automatizado cria uma instância idêntica e saudável em 30 segundos.
Quando a AWS, Google Cloud e Azure tornaram possível criar centenas de servidores virtuais com uma única chamada de API, o trabalho manual do SysAdmin virou o maior gargalo da organização.
O time de desenvolvimento lançava código novo cinco vezes por dia com metodologias ágeis, mas a infraestrutura demorava três semanas para liberar uma máquina ou abrir uma regra no firewall corporativo. A TI virou o departamento do “Não”.
🌉 A Ponte do DevOps e o Nascimento da Automação em Código
Para quebrar a barreira entre quem criava software (Dev) e quem mantinha o software (Ops), nasceu o movimento DevOps.
O SysAdmin que queria sobreviver teve que enfrentar o seu maior desafio profissional: aprender a programar e adotar ferramentas de controle de versão (Git).
A infraestrutura deixou de ser configurada digitando comandos no terminal e passou a ser tratada como software:
1. Infraestrutura como Código (IaC): Em vez de clicar no painel da nuvem, o operador descreve servidores, redes, firewalls e bancos de dados em arquivos versionados no Git usando ferramentas como Terraform, Ansible ou Pulumi.
2. Pipelines de Integração e Entrega Contínua (CI/CD): O processo de empacotar código, rodar testes de regressão e publicar em produção tornou-se 100% automatizado (GitHub Actions, GitLab CI).
3. Contêineres e Imutabilidade: Com o advento do Docker, acabou para sempre a desculpa de que “na minha máquina funciona”. A aplicação passou a empacotar seu código e suas dependências exatas em uma imagem fechada e imutável.
🚀 A Maturação Definitiva: O Engenheiro de SRE
Se o DevOps definiu a cultura de colaboração e automação de deploys, o SRE (Site Reliability Engineering) definiu a governança matemática da confiabilidade e a tolerância a falhas.
O SRE é a evolução final do SysAdmin porque ele não se limita a “manter o servidor ligado”. O SRE entende de arquitetura de software, concorrência, redes distribuídas e regras de negócio.
| Pilar de Avaliação | O SysAdmin Legado | O Engenheiro SRE Moderno |
|---|---|---|
| Ambiente de Trabalho | Terminal local, SSH, BIOS, cabos, scripts soltos | Repositório Git, Kubernetes, Terraform, Datadog/Grafana |
| Forma de Diagnóstico | Rodar top, ps aux, ler /var/log/messages após a queda |
Rastreamento distribuído (Distributed Tracing), Métricas P95/P99 e Logs Estruturados |
| Postura Diante da Falha | Reativa: espera o alarme tocar ou o usuário reclamar | Proativa: Chaos Engineering, testes de resiliência e auto-cura (self-healing) |
| Relação com o Código | Não lê código de aplicação; culpa os programadores | Analisa código da aplicação, perfila memória, detecta memory leaks e otimiza queries |
| Incentivo de Carreira | Sobreviver aos plantões e evitar que descubram os segredos | Tornar os sistemas tão confiáveis e autônomos que o plantão fica silencioso |
🗺️ O Mapa de Competências: Como Fazer a Transição na Prática
Para o profissional que deseja migrar da bancada tradicional para o SRE de alto valor — ou para o empresário que precisa requalificar sua equipe —, a transição exige quatro saltos de maturidade técnica:
1. Da Administração Manual para a Infraestrutura como Código (IaC)
– Como era: Rodar apt-get install nginx, editar o nginx.conf na mão e esquecer o que foi mudado.
– Como é: Todo o cluster, VPC, subnets e instâncias são provisionados via código declarativo versionado no Git. Se um datacenter inteiro pegar fogo na Virgínia, um único comando terraform apply ergue toda a infraestrutura idêntica em São Paulo em 15 minutos.
2. Dos Scripts Frágeis para Linguagens Estruturadas (Python / Go)
– Como era: Arquivos backup.sh desestruturados no diretório /root sem tratamento de exceções ou logs.
– Como é: O SRE escreve scripts robustos em Python ou Go, integrados às APIs da nuvem, com testes unitários, validação criptográfica de integridade e envio automático de telemetria.
3. Do Monitoramento Reativo para a Observabilidade Tridimensional
– Como era: O Zabbix dava um ping ICMP na máquina. Se o servidor respondesse ao ping, o status era considerado “verde”, mesmo que a aplicação web estivesse devolvendo tela branca ou erro 500 no checkout.
– Como é: Adoção dos três pilares da observabilidade moderna:
* Métricas: Séries temporais quantitativas (Prometheus, VictoriaMetrics).
* Logs Centralizados Estruturados: Formato JSON indexado com correlação de incidentes (Elasticsearch, Loki).
* Rastreamento Distribuído (Distributed Tracing): Capacidade de acompanhar uma requisição do cliente passando por 12 microsserviços diferentes e identificar exatamente qual consulta de banco de dados demorou 800ms para responder (OpenTelemetry, Jaeger).
4. Da Resolução Artesanal para a Automação de Auto-Cura (Self-Healing)
– Como era: O técnico acordava às 3 da manhã para digitar systemctl restart apache2.
– Como é: Orquestradores como Kubernetes ou agentes de monitoramento realizam sondas de integridade (Liveness/Readiness Probes). Se o processo travar ou não responder em 3 segundos, o próprio orquestrador destrói o contêiner doente e coloca um contêiner novo em seu lugar de forma instantânea e transparente para o usuário.
🏢 Por Que as Empresas Devem Abandonar a TI de “Bancada”
Manter uma estrutura de TI corporativa operando no modelo mental dos anos 2000 custa caro para qualquer organização moderna:
1. Dependência Crítica de Pessoas (O Fator de Ônibus – Bus Factor): Se o seu SysAdmin tradicional for atropelado por um ônibus ou pedir demissão para ir para um concorrente, sua empresa para porque ninguém mais sabe onde estão as senhas, como os backups foram programados ou como o servidor foi montado.
2. Tempo Excessivo de Retorno (MTTR – Mean Time to Recovery): Quando um incidente acontece em sistemas legados, a média de recuperação é de horas ou dias. No modelo SRE com IaC e observabilidade, o tempo médio de recuperação cai para minutos.
3. Custo de Oportunidade: Enquanto o time de TI passa a semana formatando máquinas ou lidando com chamados manuais, a empresa fica para trás na transformação digital e na proteção contra ameaças modernas como ransomware e ataques à cadeia de suprimentos.
🎯 Conclusão: O Futuro Pertence a Quem Codifica Resiliência
O SysAdmin não morreu: ele evoluiu.
Aquele mesmo profissional curioso e resolutivo que passava horas entendendo por que uma placa-mãe não ligava ou por que uma tabela do banco corrompeu continua existindo. No entanto, hoje a sua chave de fenda é o código, o seu laboratório é a nuvem pública e a sua principal ferramenta é a engenharia de confiabilidade.
Para empresas que buscam longevidade e escalabilidade, apoiar essa evolução e contar com especialistas capacitados em SRE não é uma escolha estética: é a diferença entre ser uma operação moderna e previsível ou uma empresa que vive na corda bamba do próximo apagão.
Modernização de Infraestrutura & SRE
Sua empresa ainda gerencia infraestrutura como nos anos 2000?
Ajudamos organizações a fazer a transição definitiva da TI artesanal para operações modernas: Migração para Infraestrutura como Código (Terraform/Ansible), Implantação de Kubernetes/Docker, Observabilidade Preditiva e Cultura SRE para eliminar gargalos e garantir estabilidade sem dependência de processos manuais.
Falar com Especialista em Infraestrutura
Diagnóstico técnico de maturidade e plano de modernização de TI

Guilherme Nascimento
Especialista & FundadorEspecialista em Infraestrutura, Cloud/DevOps e Cibersegurança | +10 anos de experiência prática
Profissional com mais de uma década atuando no campo de batalha da tecnologia corporativa. Especialista em arquiteturas resilientes, automação com Docker/Kubernetes, Hardening de Active Directory, Linux avançado e observabilidade SRE. Criador do ecossistema Hora Nerd, dedicado a desmistificar a tecnologia para profissionais e estudantes.